我想知道的,不是准不准,是"在算什么"
很多人用 AI 预测软件,只关心一个问题:准不准。我关心的多了个问题:它到底在算什么?
这个问题很重要。因为"准不准"是结果,"在算什么"是逻辑。只看结果,你永远不知道它什么时候会不准;看懂逻辑,你就知道什么局可以信、什么局要跳过。
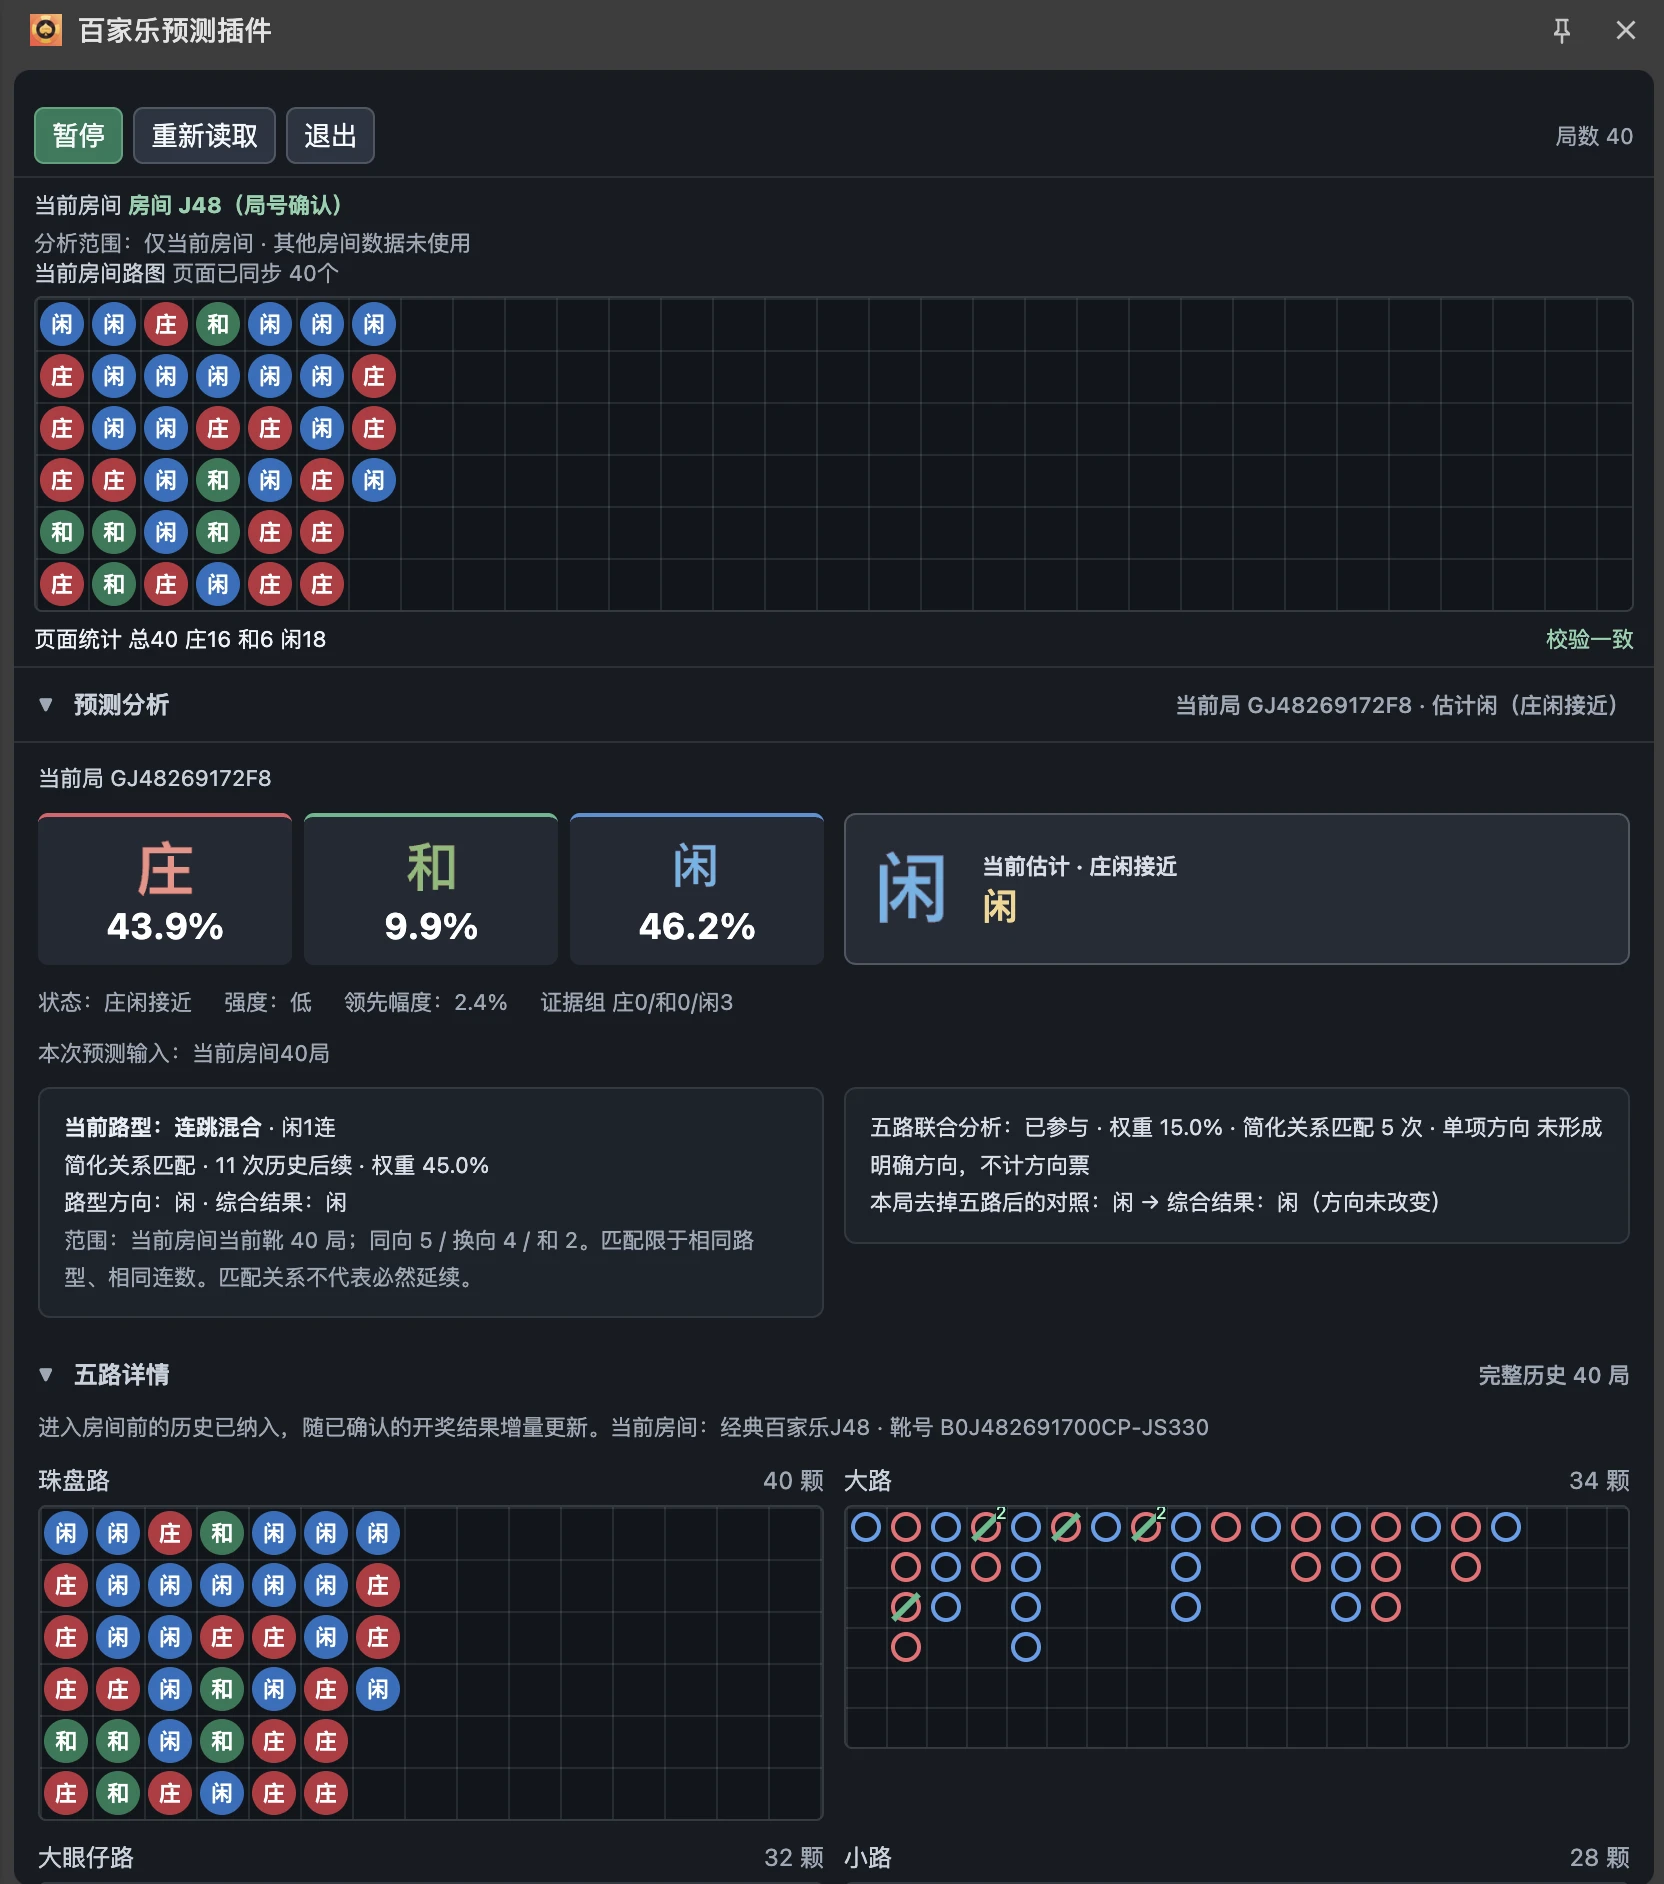
所以我开了模拟运行,跑了 100 局虚拟对局。不是为了验证胜率,是为了观察:在各种路型下,软件的倾向分数是怎么变的。我想看的,是它的"算分过程"。
100局观察:软件在算"证据分"
100 局看下来,我总结出软件的计算逻辑:它不是在算"下一局开红还是开蓝"(这算不出来,神仙也算不出来),它是在算"当前路型下,支持红的证据有多少分、支持蓝的证据有多少分"。
证据来自三个地方:
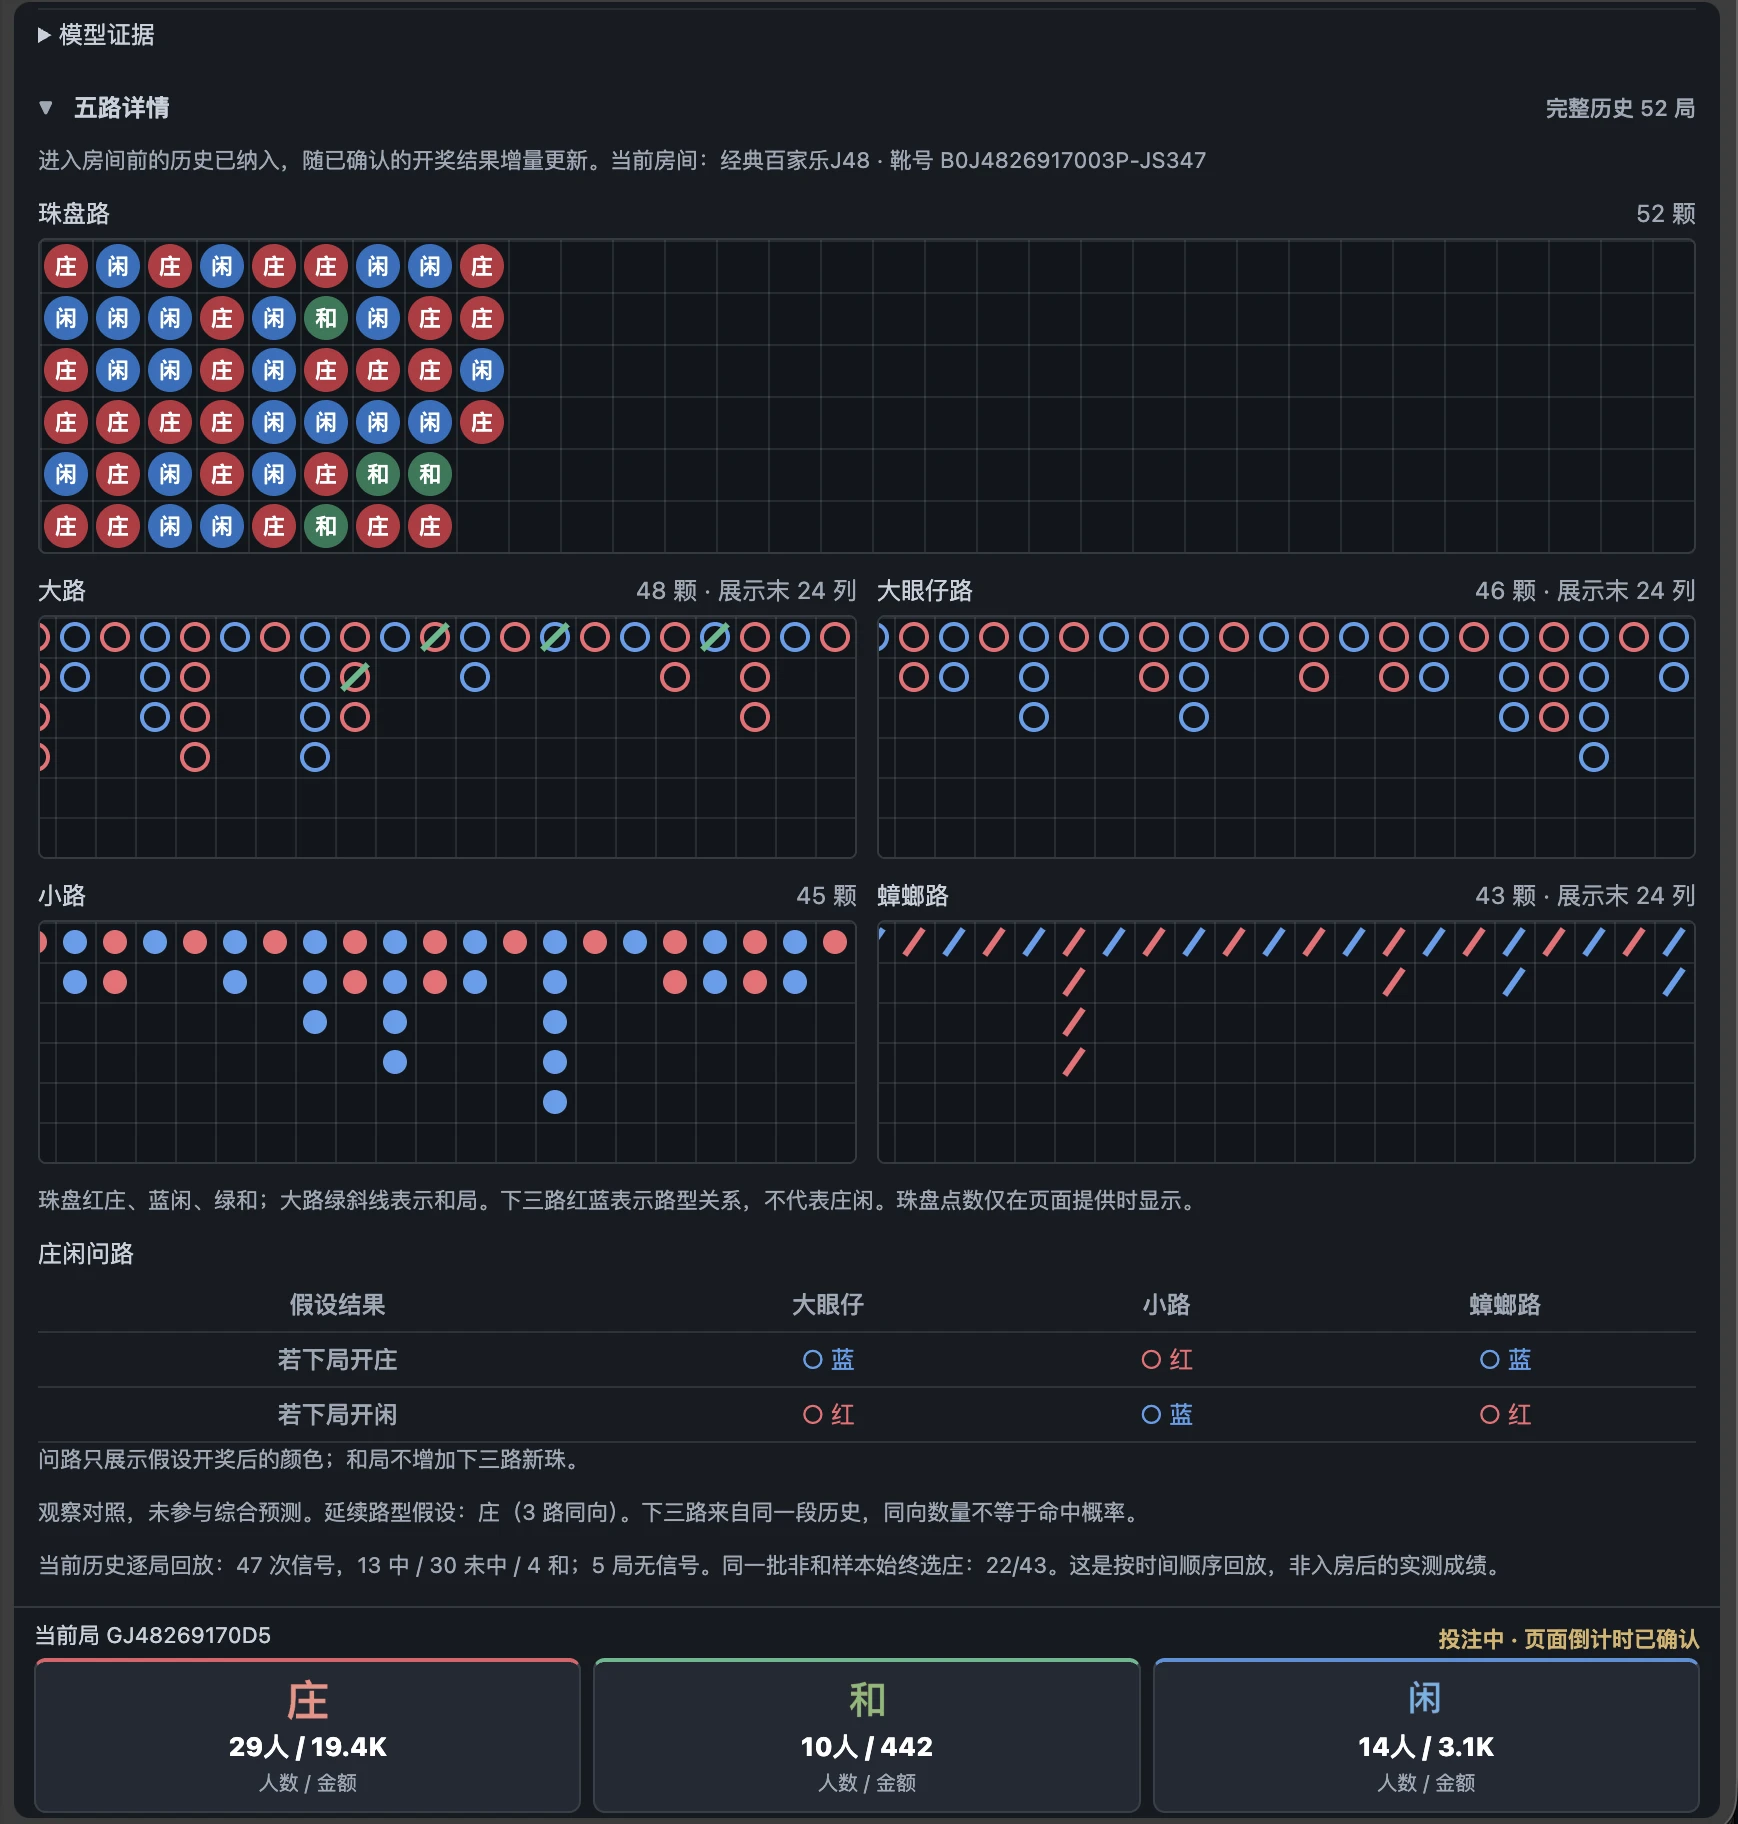
大路证据:当前大路的形态。连红五局,大路证据偏红;庄闲交替,大路证据中性;刚断缆,大路证据偏向"趋势反转"那一边。
下三路证据:大眼仔、小路、蟑螂路的状态。三路全红,下三路证据强烈偏红;两红一蓝,偏红但打折;三路打架,证据互相抵消,接近中性。
动态权重:软件会根据当前房间近期的路型特征,调整两类证据的权重。长龙房,大路证据权重高;碎路房,下三路证据权重高——因为碎路时大路本身没什么信息量,下三路的细微变化反而更重要。
最后的倾向分数,就是"红方证据总分 vs 蓝方证据总分"的对比结果。68% 偏红,意思是"支持红的证据有 68 分";52%,意思是"双方证据差不多,红方多 2 分"。
三个发现
发现一:软件不预测"结果",只评估"证据"。这个区别很关键。预测结果是算命,评估证据是分析。软件做的事,是把当前路型里所有支持红、支持蓝的证据量化、加权、对比,给你一个分数。它没说"下一局一定开红",它说的是"现在的证据更支持红"。
发现二:证据分是动态的。同一条大路连红,刚连到第 3 局和连到第 8 局,软件给的分数不一样——因为"连红长度"本身也是证据,连得越长,"趋势延续"的证据越强,但"均值回归"的证据也开始累积。软件在算的,是这两股证据的实时对比。
发现三:低分不是"算错了",是"证据不足"。55% 以下的局,我以前觉得是软件"没算准"。100 局看下来,那些局的共同点是:大路碎、下三路打架、动态权重调来调去——证据本身就是一团浆糊,软件能算出 55%,已经是它诚实的表现。证据不足的时候,硬给高分才是错的。
看懂"算什么"之后,我的用法变了
以前,我看软件的倾向分数,问的是"这局跟不跟"。现在,我看分数,问的是"证据充分吗"。
68% 的局,我会点进依据看一眼:这 68 分里,大路证据占多少、下三路占多少。如果大路证据占大头,说明这是趋势局,跟;如果下三路证据占大头,说明这是结构局,更要认真看——下三路的信号通常更持久。
55% 的局,我直接跳过,不是因为"分数低",是因为"证据不足"。证据不足的局,跟了就是赌,赌不是我的策略。
还有一个变化:我不再纠结"软件这局为什么错了"。以前跟错一局,我就怀疑软件;现在我会去看那一局的证据构成——很多时候,错的那一局,证据本身就是 58% 对 42% 这种接近的比分,错了很正常。理解了"算什么",就接受了"会错",接受了"会错",心态就稳了。
100局模拟的真正收获
这 100 局虚拟对局,最大的收获不是胜率数据,而是一句话:AI 红蓝预测软件算的不是"下一局开什么",算的是"现在的证据支持哪边"。
这句话,改变了我和软件的关系。以前我是"使用者",软件给我分数,我决定跟不跟;现在我是"合伙人",软件负责算证据分,我负责定纪律(55% 以下跳过、60% 以上认真看)。分工明确,配合默契。
如果你也在用 AI 红蓝预测软件,我建议你也跑 100 局模拟。不为别的,就为了亲眼看看,它到底在算什么。看懂了,你才知道什么时候该信它,什么时候该信自己的纪律。这 100 局,是你和软件建立信任的最快方式。